5.1. Formatos de codificação e evolução de esquema
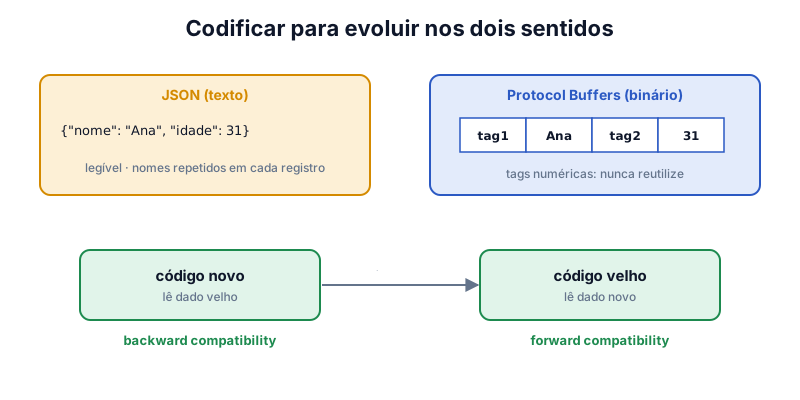
Codifique para que código novo leia dado velho e código velho leia dado novo.
Resumo
- Compatibilidade retroativa (backward): código novo lê dado velho. Futura (forward): código velho lê dado novo.
- Formatos da linguagem (pickle, Java Serializable): presos à linguagem, inseguros e sem versionamento. Evite.
- JSON/XML/CSV: legíveis, mas ambíguos com números e binários; esquema opcional (JSON Schema).
- Protocol Buffers: campos com tags numéricas; nunca reuse tag; campo novo precisa ser opcional ou ter padrão.
- Avro: esquema do escritor + do leitor, resolvidos por nome; bom para dumps e esquemas gerados. Esquema = documentação viva.
Perguntas-chave
responda de cabeça, depois abraPor que compatibilidade nos dois sentidos importa?
Em rolling upgrade, versões velhas e novas do código convivem e leem os mesmos dados; os dois lados precisam se entender.
Por que não reutilizar uma tag do Protocol Buffers?
Dados antigos gravados com aquela tag seriam lidos como o campo novo, com tipo e significado errados.
O que o Avro faz quando os esquemas do escritor e do leitor diferem?
Compara os dois por nome de campo: ignora campos que o leitor não conhece e usa valores padrão para campos que o escritor não gravou.
Exercícios de fixação
0/5 respondidas1.
Durante um rolling upgrade, um nó com código antigo lê um registro gravado pelo código novo, que tem um campo extra. O que é preciso?
2.
Qual o problema de usar
pickle do Python para dados trocados entre serviços?3.
Um campo
obrigatorio novo é adicionado num esquema Protobuf usado em produção. O que quebra?4.
JSON tem um problema conhecido com IDs numéricos grandes (ex.: 2⁵³ + 1). Qual?
5.
Por que o Avro é prático para despejar uma tabela de banco cujo esquema muda com frequência?