4.3. Busca de texto completo e embeddings vetoriais
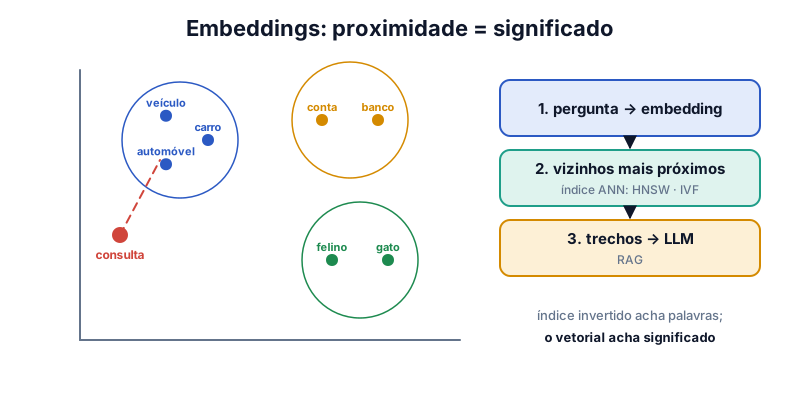
Índice invertido acha palavras; embedding acha significado. Busca vetorial é a base de RAG e recomendação.
Resumo
- Índice invertido: termo → lista de documentos (postings). Base do Lucene/Elasticsearch. Suporta erro de digitação e relevância.
- Índice multidimensional (R-tree, geohash): busca por região, como latitude e longitude ao mesmo tempo.
- Embedding: vetor numérico gerado por um modelo de ML; textos parecidos ficam próximos. Mede por cosseno ou distância.
- Busca vetorial (vizinhos mais próximos) acha por significado: base de RAG com LLMs, busca semântica e recomendação.
- Índices aproximados (ANN): IVF (agrupa em clusters) e HNSW (grafo em camadas). Trocam precisão por velocidade.
Perguntas-chave
responda de cabeça, depois abraQual a diferença entre busca full-text e busca vetorial?
Full-text casa termos (palavras e variações); vetorial compara significado, achando "carro" ao buscar "automóvel" mesmo sem palavra em comum.
Por que índices vetoriais são aproximados?
Comparar o vetor da consulta com milhões de vetores de alta dimensão é caro; ANN examina só regiões promissoras e aceita perder alguns vizinhos.
Onde a busca vetorial entra num sistema com LLM?
No RAG: o sistema transforma a pergunta em embedding, busca os trechos mais próximos e os envia ao LLM como contexto para a resposta.
Exercícios de fixação
0/5 respondidas1.
Um chatbot de suporte precisa achar trechos do manual relevantes para a pergunta do usuário, mesmo com palavras diferentes. Qual índice usar?
2.
Num índice invertido, cada termo aponta para:
3.
"Restaurantes num retângulo do mapa" exige filtrar latitude e longitude juntas. O índice adequado é:
4.
Qual é o trade-off de índices HNSW e IVF?
5.
A equipe troca o modelo de embedding por uma versão nova. O que acontece com o índice vetorial?