2.2. Confiabilidade, escalabilidade e manutenibilidade
Tolere falhas, descreva a carga antes de escalar e projete para quem vai operar e mudar o sistema.
Resumo
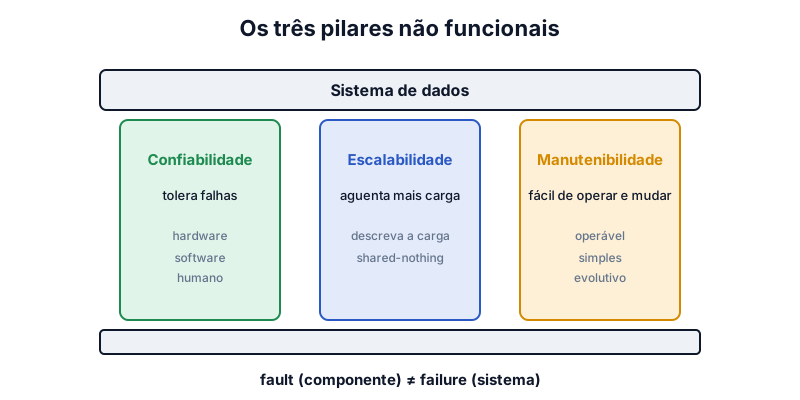
- Falha (fault) ≠ defeito do sistema (failure). Tolerância a falhas impede que uma vire a outra.
- Falhas de hardware são aleatórias; de software são correlacionadas; erro humano é a causa mais comum de queda.
- Escalabilidade: como lidar com mais carga. Descreva a carga (parâmetros) antes. Shared-nothing escala horizontalmente.
- Operabilidade: monitorar, automatizar, ter bons padrões. Simplicidade: remover complexidade acidental com abstrações.
- Evolutividade: facilidade de mudar. Escale para a carga de hoje × 10, não para um futuro imaginado.
Perguntas-chave
responda de cabeça, depois abraQual a diferença entre fault e failure?
Fault é um componente se desviando do esperado (um disco, um processo); failure é o sistema como um todo deixando de servir o usuário.
Por que bugs de software são mais perigosos que falhas de disco?
Discos falham de forma independente; um bug atinge todos os nós ao mesmo tempo (ex.: segundo bissexto), causando falha em cadeia.
O que é arquitetura shared-nothing?
Cada nó tem sua própria CPU, memória e disco, coordenando-se apenas pela rede; escala adicionando máquinas comuns.
Exercícios de fixação
0/5 respondidas1.
Um disco falha e o sistema continua atendendo pela réplica. Na terminologia do livro, houve:
2.
Todos os servidores de uma frota travam no mesmo segundo por um bug de tratamento de data. Que tipo de falha é essa?
3.
Antes de discutir "o sistema escala?", o capítulo pede para:
4.
Qual medida combate melhor o erro humano, principal causa de quedas?
5.
Remover complexidade acidental com uma boa abstração melhora principalmente: