9.1. Falhas parciais, redes e relógios não confiáveis
Sem resposta não diz se o outro morreu; relógios mentem. Projete supondo os dois.
Resumo
- Falha parcial: parte do sistema quebra e parte funciona, de forma não determinística. É o que torna distribuído difícil.
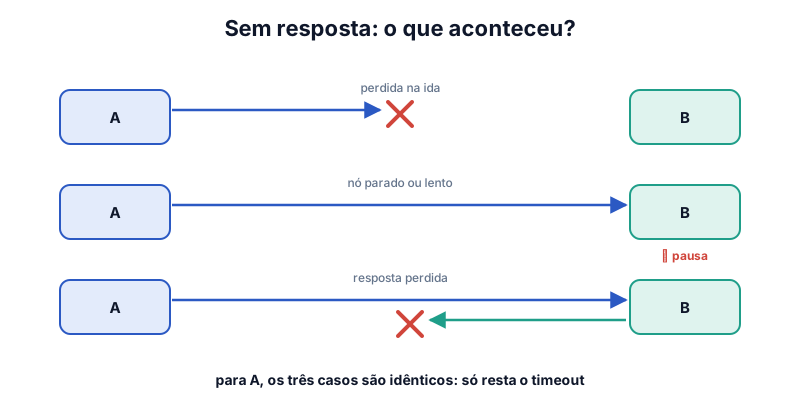
- Rede assíncrona: pacote pode se perder, atrasar ou duplicar. Sem resposta, não se sabe o que houve. Use timeouts.
- Timeout curto: falso positivo e failover à toa. Longo: espera demais. Atrasos vêm de filas (rede, CPU, VM).
- Relógio de parede (NTP) pode pular para trás; monotônico só mede intervalos. Desvio entre nós é normal.
- Ordenar eventos por timestamp de nós diferentes é perigoso (LWW perde escritas). Spanner usa intervalo de confiança.
Perguntas-chave
responda de cabeça, depois abraPor que não dá para distinguir nó morto de rede lenta?
Em ambos os casos a resposta não chega dentro do prazo; o remetente só vê o silêncio.
Qual relógio usar para medir quanto tempo uma operação levou?
O monotônico: ele só avança, enquanto o relógio de parede pode ser ajustado pelo NTP e até voltar.
Como o Spanner lida com incerteza de relógio?
Cada timestamp é um intervalo [mais cedo, mais tarde]; antes de confirmar, a transação espera o intervalo passar para garantir ordem.
Exercícios de fixação
0/5 respondidas1.
O serviço A chama B e não recebe resposta em 5 s. O que A pode concluir?
2.
Para medir a duração de uma requisição, o código deve usar:
3.
Dois nós gravam a mesma chave com last write wins; o relógio do nó B está 200 ms adiantado. O que pode acontecer?
4.
Por que a latência de rede varia tanto em datacenters?
5.
Um timeout de detecção de falha muito longo resulta em: